Kamu ngetik pertanyaan di Google, hasil muncul dalam hitungan detik, dan kamu lanjut scroll tanpa pernah mikirin apa yang terjadi di balik sistem Google. Tapi begitu mulai optimasi website, semua jawaban soal kenapa konten kamu gak muncul ternyata balik ke sana: ke delapan komponen yang membentuk search engine.
Kebanyakan panduan SEO langsung lompat ke teknik tanpa menjelaskan kenapa teknik itu bekerja. Kamu ikuti checklist tanpa paham logikanya. Nah, di sini saya bakal bedah satu per satu komponennya, dan hubungkan masing-masing ke aksi optimasi yang bisa kamu langsung terapkan di website kamu.
Key takeaways
Search engine punya delapan komponen inti mulai dari crawler, indexer, database index, query processor, ranking algorithm, link analysis, SERP, dan search logs, yang bekerja sebagai satu sistem terintegrasi, bukan bagian yang berdiri sendiri.
Google tidak mencari internet secara real-time, melainkan mencari salinan indeksnya sendiri. Ranking pun berlangsung dua lapis: sinyal murah seperti BM25 dan PageRank menyaring kandidat, baru model AI seperti BERT dan MUM melakukan re-ranking.
Tiap komponen punya batasan spesifik: crawler cuma bisa lihat halaman yang sudah ditemukan, indexer punya ambang kualitas minimum, dan ranker bersaing ketat untuk memperebutkan posisi di halaman satu.
Faktor ranking punya bobot yang tidak sama. Relevansi konten, otoritas backlink, dan pengalaman pengguna jauh lebih berpengaruh dibanding faktor teknis seperti kecepatan loading.
AI Overviews dan AI Mode mengubah lanskap klik secara signifikan, dengan riset menunjukkan mayoritas pencarian Google sekarang berakhir tanpa klik sama sekali ke luar halaman hasil.
Apa Itu Search Engine?
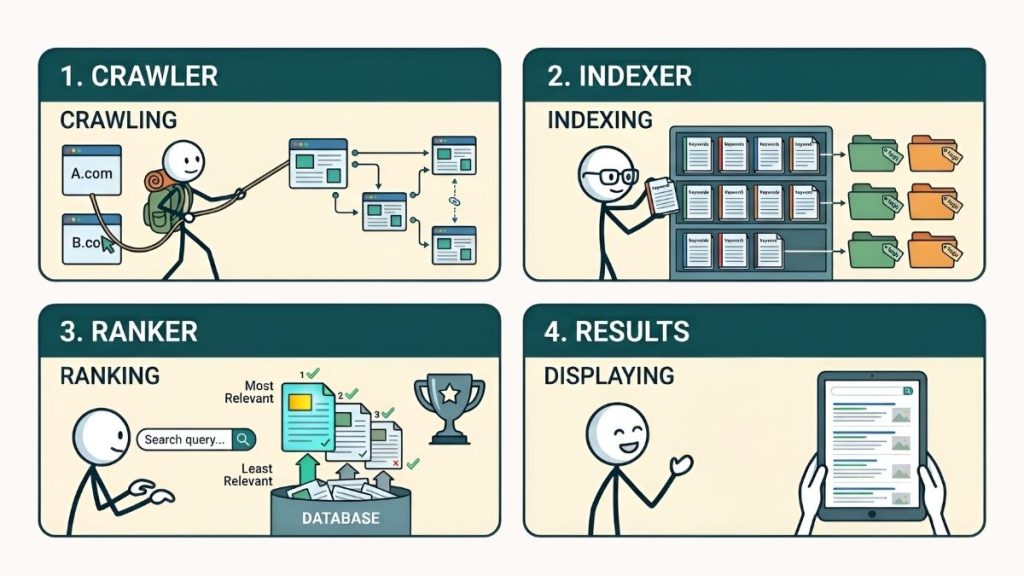
Search engine itu program yang kerjanya menjelajahi internet, ngumpulin data dari miliaran halaman, terus ngasih kamu hasil yang paling relevan pas kamu ngetik sesuatu. Lalu, bagaimana sih search engine ini bekerja?
- Crawler menjelajahi internet, mengumpulkan halaman satu per satu. Bayangkan mobil pemadam kebakaran yang keluar setiap kali ada alarm.
- Indexer membaca setiap halaman, memecahnya jadi kata-kata, dan menyimpannya ke database raksasa.
- Ranker menentukan urutan halaman mana yang muncul duluan saat ada kueri.
Google sendiri menjelaskannya begini: “Kami menggunakan automated software yang disebut web crawlers untuk menjelajahi web secara regular.” Tapi itu cuma satu komponen dari delapan.
Masalahnya, Google tidak mencari internet secara real-time. Google mencari indeksnya yaitu salinan internet yang dibangun dan dipelihara terus-menerus oleh sistem mereka. Jadi ketika kamu mengetik “cara membuat kopi,” kamu tidak sedang mencari 1 triliun halaman web di internet. Kamu mencari di dalam database Google yang sudah disiapkan sebelumnya.
Google menggunakan dua lapis ranking. Sinyal murah seperti BM25 dan PageRank memfilter jutaan halaman jadi ribuan kandidat. Baru setelah itu, model machine learning seperti BERT dan MUM melakukan re-ranking untuk menentukan urutan akhir. Kebanyakan halaman tidak pernah sampai ke tahap AI.
Mengapa Komponen Search Engine Penting Dipahami?
Karena kalau kamu nggak tahu cara sistem ini bekerja, kamu nggak bisa kerja sama dengannya. Search engine umumnya punya tiga komponen utama: Crawler, Indexer, Ranker. Masing-masing punya fungsi spesifik dan batasan spesifik.
- Crawler cuma lihat salinan internet, yaitu indeks yang terakhir di-crawl search engine. Bukan internet real-time. Kalau halaman kamu belum di-crawl, Google nggak tahu halaman itu ada.
- Indexer nggak bisa index semua halaman. Ada kualitas minimum agar sebuah konten bisa diindex. Kalau kontennya terlalu tipis atau duplikat, indexer nggak mau masukin.
- Ranker nggak bisa rank semua halaman. Ada kompetisi ketat untuk memperebutkan halaman 1 di mesin pencari. Kalau halaman lain lebih relevan atau lebih autoritatif, ranker bisa aja nggak mau rank halaman kamu.
Kalau kamu nggak tahu batasan ini, kamu nggak bisa prediksi apa yang bisa dan nggak bisa dilakukan search engine. Dan kamu cuma bisa tebak-tebakan.
8 Komponen Search Engine Utama dan Fungsinya
Delapan komponen berikut membentuk fondasi setiap search engine. Mulai dari bagaimana crawler menemukan konten, indexer mengorganisasikannya, database menyimpannya, query processor memahami kueri, ranking algorithm menentukan urutan, link analysis mengukur otoritas, SERP menampilkan hasilnya, hingga search logs mencatat perilaku pengguna.
Crawler (Spider/Bot): Penjelajah Web
Crawler, yang juga dikenal sebagai spider atau bot, adalah program otomatis yang tugasnya cuma satu: menjelajah internet buat nemuin halaman web baru. Seperti namanya, cara kerja crawler ini seperti jaring laba-laba: mulai dari satu URL, mengikuti link dari halaman ke halaman, lalu mengumpulkan informasi di sepanjang jalan.
Sebenernya crawler gak jalan dari nol. Sebelum mulai, dia udah punya daftar URL yang mau didatengin, yang sumbernya dari sitemap, seed list, atau link yang ketemu di crawl sebelumnya. Dari daftar itu dia baru mengunjungi link-link berikutnya.
Crawler paling terkenal adalah Googlebot, tapi setiap search engine (selain Google) juga memiliki crawler sendiri. Kalau kamu mau pelajari lebih dalam, Google menjelaskan cara kerja Googlebot, frekuensi crawling, dan rendering di dokumentasi crawling infrastructure mereka.
Fun fact! Website yang susah dijelajahi bisa aja dilewati oleh crawler. Ini terjadi karena setiap crawler punya crawl budget, yaitu jatah waktu dan resource yang terbatas untuk menjelajahi suatu website. Kalau budget itu habis kepakai buat hal-hal yang gak penting, halaman yang sebenarnya penting jadi gak kebagian giliran di-crawl.
Contoh: arsitektur website yang menciptakan jutaan URL duplikat (parameter tracking, session ID, faceted navigation) akan membuat crawler mengakses halaman yang sama berkali-kali, sehingga ada halaman lain yang bisa tertinggal. Contoh lainnya adalah ketika konten halaman hanya muncul saat JavaScript aktif; halaman seperti ini akan sulit dibaca oleh crawler yang gak punya kemampuan membaca JavaScript.
Indexer: Pengindeks Halaman Web
Setelah crawler menemukan halaman, tugas indexer dimulai. Indexer membaca dan menganalisis konten halaman web, memproses teks, gambar, metadata, dan struktur HTML untuk memahami apa isi halaman tersebut, lalu menyimpan hasilnya ke dalam database.
Cara indexer menyimpan data ini disebut inverted index. Alih-alih menyimpan data per halaman (forward index), indexer membalik strukturnya: setiap kata kunci dihubungkan ke daftar halaman yang mengandung kata tersebut.
Ketika kamu mengetik “cara membuat kopi,” search engine gak perlu memeriksa semua halaman web satu per satu. Ia cukup melihat daftar halaman yang mengandung kata “cara,” “membuat,” dan “kopi” di inverted index. Dengan begitu, pencarian yang seharusnya memakan waktu berjam-jam selesai dalam hitungan milidetik.
Tapi inverted index cuma jawab pertanyaan “halaman mana yang punya kata ini?”, belum jawab “halaman mana yang paling relevan?” Di sinilah indexer melakukan tugas tambahan. Ia mencatat di mana kata itu muncul (judul, heading, atau isi paragraf), seberapa dekat kata-kata kunci itu satu sama lain, dan seberapa sering kata itu diulang secara wajar dalam halaman. Semua sinyal ini membantu search engine menyusun urutan relevansi, bukan cuma tahu halaman mana yang “mengandung” kata tertentu.
Selain posisi dan struktur, indexer juga memperhatikan elemen penekanan seperti heading, bold, atau italic. Google sendiri pernah mengonfirmasi bahwa elemen-elemen ini membantu Google memahami fokus topik suatu halaman, khususnya memahami bagian mana yang dianggap penting oleh penulisnya sendiri. Karena itu, struktur heading dan penekanan teks yang wajar (bukan yang dipaksain atau di-spam) tetap relevan diperhatikan dalam praktik SEO.
Sebagai tambahan, indexer juga gak cuma baca teks biasa. Dia juga mem-parsing structured data kayak JSON-LD buat ngerti konteks halaman lebih detail, misalnya jenis konten, rating, atau harga produk.
Cara parsing ini bisa berubah sewaktu-waktu. Baru-baru ini, Google Search Central mengumumkan perubahan pada parser JSON-LD mereka, khususnya soal HTML unescaping yang sekarang cuma satu pass, bukan dua. Praktiknya, kalau structured data kamu pakai double-escaped entity seperti & & atau ✔, entity itu gak lagi di-unroll otomatis dan bisa bikin data terbaca salah. Google menyarankan pakai standard JSON escape atau Unicode hexadecimal escape seperti \u0026 sebagai gantinya.
Database Index: Gudang Informasi Raksasa
Database index adalah tempat penyimpanan informasi yang telah dikumpulkan oleh crawler dan diorganisir oleh indexer. Database index search engine ini dirancang khusus untuk pencarian super cepat di antara miliaran, bahkan ratusan miliar dokumen. Google menyimpan indeksnya di ribuan server yang tersebar di seluruh dunia, dengan skala infrastruktur yang estimasinya bisa mencapai ratusan ribu hingga jutaan server.
Database index inilah yang memungkinkan search engine menampilkan hasil pencarian dalam hitungan milidetik. Tanpa struktur indeks yang efisien, search engine harus memeriksa setiap halaman web setiap kali ada kueri baru. Bayangkan berapa lama waktu tunggu yang diperlukan untuk itu.
Inilah mengapa halaman website yang “diindeks” itu penting karena jika halaman kamu tidak ada di database index, halaman tersebut, bagi search engine, sama saja tidak pernah ada.
Query Processor: Penerjemah Kata Kunci Pengguna
Ketika kamu mengetikkan kata kunci di Google, query processor mulai bekerja. Komponen ini bertugas memahami maksud di balik kueri kamu. Query processor tidak hanya mencocokkan kata kunci secara harfiah, tapi menganalisis konteks, memperbaiki kesalahan ketik, dan bahkan memahami sinonim.
Contoh: ketika seseorang mengetik “cara membuat kopi tanpa mesin,” query processor memahami bahwa pengguna mencari panduan praktis, bukan artikel sejarah kopi. Komponen ini menggunakan teknologi pemrosesan bahasa alami (NLP) untuk membedakan tujuan pencarian antara kueri informasional, navigasional, dan transaksional.
Ketiga tujuan pencarian (search intent) mencerminkan tahap berbeda dalam perjalanan pengguna. Kueri informasional muncul saat orang mencari tahu sesuatu, misalnya “cara membuat kopi tanpa mesin.” Kueri navigasional muncul saat orang udah tahu tujuannya dan cuma butuh jalan ke sana, misalnya “login Gmail.” Sementara kueri transaksional muncul saat orang siap mengambil tindakan, misalnya “beli french press online.”
Ketiga jenis ini butuh jenis konten yang beda, mulai dari panduan, halaman resmi, atau halaman produk. Jadi salah menebak intent bisa bikin kontenmu gak muncul meskipun kata kuncinya cocok.
Bagi SEO, ini berarti kamu harus memahami search intent dan fokus pada maksud pengguna, alih-alih sekadar mengejar volume pencarian kata kunci.
Ranking Algorithm: Otak Penentu Posisi
Ranking algorithm adalah komponen paling kompleks dalam search engine. Setelah query processor memahami kueri, ranking algorithm menentukan urutan halaman yang akan ditampilkan. Algoritma ini mempertimbangkan ratusan faktor seperti relevansi konten, kualitas backlink, kecepatan loading, pengalaman pengguna, dan banyak lagi.
Google mendokumentasikan sejumlah “ranking systems” resmi mereka di halaman Ranking Systems Guide. Di antaranya ada PageRank, salah satu core ranking system tertua yang menilai halaman berdasarkan struktur link, dan BERT, sistem AI yang membantu memahami makna di balik kombinasi kata dalam kueri.
Selain BERT, Google juga punya beberapa sistem AI serupa yang tugasnya beda-beda: RankBrain membantu memahami hubungan antar kata dan konsep meski kata yang dicari gak persis sama dengan yang ada di halaman, Neural matching mencocokkan konsep dalam kueri dengan konsep di halaman, dan Passage ranking menilai relevansi per bagian (bukan seluruh halaman) terhadap kueri.
Satu hal yang pasti, Google terus memperbarui ranking algorithm mereka. Misalnya, Helpful Content System, yang awalnya diumumkan tahun 2022, resmi melebur jadi bagian dari core ranking systems pada Maret 2024, sebagai upaya Google mengutamakan konten yang benar-benar membantu pengguna.
Tapi ratusan faktor ranking tidak semuanya memiliki bobot yang sama. Google sendiri mengonfirmasi bahwa faktor seperti relevansi konten, otoritas backlink, dan pengalaman pengguna memiliki bobot yang jauh lebih besar daripada faktor teknis seperti kecepatan loading. Artinya, fokus optimasi kamu seharusnya ada di faktor-faktor dengan dampak terbesar.
Link Analysis: Pengukur Otoritas Halaman Web
Link analysis adalah komponen yang menilai otoritas sebuah halaman berdasarkan tautan yang mengarah ke sana. Konsep ini paling terkenal melalui PageRank, algoritma asli Google yang menghitung kualitas dan jumlah backlink untuk menentukan otoritas halaman. Konsep PageRank pertama kali dijelaskan oleh Larry Page dan Sergey Brin dalam paper “The Anatomy of a Large-Scale Hypertextual Web Search Engine” (1998).
Cara kerja link analysis simpel: jika banyak website berkualitas memberikan link ke halaman kamu, halaman tersebut dianggap memiliki otoritas. Tapi bukan semua backlink berbobot sama. Satu backlink dari website dengan otoritas tinggi jauh lebih berharga daripada seratus backlink dari website yang tidak dikenal.
Tapi PageRank bukan satu-satunya sinyal otoritas. Ada juga konsep topical relevance: backlink dari website yang relevan dengan topik kamu dianggap lebih berharga daripada backlink dari website otoritas tinggi yang gak nyambung topiknya. Sebuah website fitness mendapat backlink dari website kesehatan otoritas tinggi lebih berharga daripada backlink dari website teknologi.
Perlu dicatat, topical relevance sendiri bukan sistem resmi yang diumumkan Google seperti PageRank atau BERT melainkan konsep yang udah lama jadi acuan umum di dunia SEO, berakar dari riset soal analisis topik dalam struktur link seperti “Topic-Sensitive PageRank” yang dilakukan Haveliwala (2002).
Search Interface (SERP): Wajah Search Engine ke Pengguna
Search Engine Results Page (SERP) adalah tampilan yang kamu lihat setelah melakukan pencarian. SERP mencakup daftar link biru, featured snippets, knowledge panels, local packs, video results, People Also Ask (PAA), image carousels, dan berbagai elemen lainnya. Setiap elemen dirancang untuk menjawab kueri pengguna secepat mungkin.
Bagi SEO, memahami SERP sangat penting. Featured snippet, misalnya, memberikan jawaban langsung di bagian atas halaman hasil. Jika konten kamu berhasil “mencuri” posisi featured snippet, kamu mendapatkan visibilitas jauh lebih tinggi daripada hasil organik biasa. Tapi untuk mencapai itu, konten kamu harus benar-benar menjawab pertanyaan pengguna dengan jelas dan langsung.
Elemen SERP paling signifikan belakangan ini adalah AI Overviews dan AI Mode, dua fitur berbasis AI yang mengubah cara Google menampilkan hasil pencarian. AI Overviews muncul di bagian paling atas halaman hasil sebagai rangkuman yang disintesis dari berbagai sumber, sementara tautan organik biasa tetap tampil di bawahnya. AI Mode lebih jauh lagi: ia menggantikan SERP tradisional sepenuhnya dengan antarmuka percakapan yang menjawab kueri secara langsung, lengkap dengan sitasi ke sumber.
Terus terang, sebagai praktisi SEO, fitur ini bikin frustrasi. Data dari SISTRIX (Maret 2026) mencatat CTR posisi satu organik anjlok dari 27% ke serendah 11% pada kueri yang menampilkan fitur AI di German. Di Amerika Serikat, riset SparkToro yang dilakukan bulan Januari hingga April (berbasis data Similarweb) mencatat 68,01% pencarian Google sekarang berakhir tanpa satu klik pun keluar halaman hasil, naik dari 60,45% di tahun 2024.
Artinya, ranking nomor satu yang dulu menjadi tujuan utama strategi SEO sekarang bisa aja gak menghasilkan traffic sama sekali kalau AI Overview udah “mencuri” jawabannya duluan. Makanya, tidak heran kalau sekarang SEO sudah mulai mengintegrasikan optimasi AI SEO, atau yang juga dikenal dengan GEO, agar brand website bisa dimention oleh AI.
Search Logs & Analytics: Sumber Data Perilaku Pengguna
Search logs dan analytics mencatat perilaku pengguna seperti halaman mana yang diklik, berapa lama pengguna tinggal di halaman tersebut, dan apakah pengguna kembali ke hasil pencarian setelah mengklik sebuah tautan. Data ini digunakan sebagai sinyal ranking.
Jika banyak pengguna mengklik halaman kamu tetapi langsung kembali ke hasil pencarian (pogosticking), ini sinyal negatif bagi ranking kamu. Sebaliknya, jika pengguna mengklik halaman kamu dan menghabiskan waktu di sana, ini sinyal positif. Inilah mengapa click-through rate (CTR) dan dwell time menjadi faktor ranking yang tidak bisa diabaikan. Search engine belajar dari perilaku pengguna untuk meningkatkan kualitas hasil pencarian di masa depan.
Sebagai catatan, ini bukan sesuatu yang selama ini diakui terbuka oleh Google. Perwakilan mereka, termasuk mantan kepala tim webspam Matt Cutts, justru berulang kali meremehkan peran CTR sebagai faktor ranking di publik. Kebenarannya baru muncul lewat sidang antitrust DOJ v. Google tahun 2023, ketika Pandu Nayak, VP Search Google, bersaksi di bawah sumpah bahwa sistem internal bernama NavBoost yang mengolah data klik pengguna, termasuk pola pogosticking dan durasi kunjungan adalah salah satu sinyal ranking terpenting mereka. Kesaksian ini jadi konfirmasi resmi pertama dari pihak Google sendiri soal peran data klik dalam ranking, sesuatu yang selama bertahun-tahun cuma jadi spekulasi di komunitas SEO. Sumber: https://searchengineland.com/google-abc-ranking-signals-455360
Bagaimana Komponen-Komponen Search Engine Bekerja Bersama
Delapan komponen di atas tidak bekerja secara terpisah. Mereka membentuk satu sistem terintegrasi. Memahami bagaimana komponen-komponen ini terhubung membantu kamu melihat SEO sebagai strategi menyeluruh.
Alur Data: Dari URL Baru ke Database Indeks
Proses dimulai ketika crawler menemukan URL baru. URL ini bisa ditemukan melalui tautan dari halaman lain, sitemap XML, atau Google Search Console. Setelah URL ditemukan, crawler mengunduh halaman dan mengirimkannya ke indexer. Indexer membaca konten, menganalisis teks dan metadata, lalu menyimpan hasilnya ke database index.
Selama proses ini, link analysis juga berjalan. Crawler mencatat tautan yang ditemukan di halaman, dan tautan-tautan ini nantinya digunakan untuk mengukur otoritas website dan URL halaman tersebut.
Seluruh proses ini berlangsung secara terus-menerus. Google tidak hanya meng-crawl halaman sekali dan selesai. Halaman populer bisa di-crawl ulang setiap hari, sementara halaman yang jarang berubah mungkin hanya diperiksa sekali sebulan.
Inilah mengapa freshness content penting. Begitu kamu memperbarui artikel lama dengan informasi terbaru, crawler akan menemukan perubahan tersebut, indexer akan memproses ulang, dan database index akan diperbarui.
Saat Pengguna Mengetik: Query Processor hingga Ranking
Dari miliaran kueri yang diproses Google tiap hari, query processor menganalisis maksud di balik tiap kata, lalu menarik kandidat halaman dari database index. Kandidat-kandidat ini dinilai oleh ranking algorithm, dengan sinyal dari link analysis ikut menambah bobot otoritas. Hasil akhirnya tampil di SERP lengkap dengan snippet dan elemen lain.
Setelah pengguna mengklik sebuah hasil, search logs mulai mencatat perilaku. Apakah pengguna tinggal lama di halaman? Atau langsung kembali ke SERP? Data ini menjadi masukan untuk ranking algorithm di masa depan. Siklus ini berulang terus-menerus, membuat search engine semakin pintar dari waktu ke waktu.
Kesimpulan
Search engine bekerja lewat siklus yang saling terhubung: crawler nemuin dan baca halaman, hasilnya diproses dan disimpan, lalu dipakai buat nentuin posisi saat ada yang mencari, dan hasil interaksi pengguna balik lagi jadi masukan buat proses berikutnya. Karena komponen-komponen ini saling terhubung, masalah di satu bagian bisa berdampak ke bagian lain.
Memahami alur ini ngebantu kamu ngeliat dari mana sebenarnya suatu masalah berasal, apakah dari tahap crawler dan indexer nemuin serta baca halaman, atau dari tahap ranking dan link analysis nentuin posisinya. Pemahaman ini yang jadi dasar buat ngeliat SEO sebagai satu sistem yang saling terkait satu sama lain.
Siapa Pici?
Saya Pici, dengan nama asli Muhammad Fikri Abdul Zaki. Sudah 10+ tahun di dunia SEO, dan saya meyakini bahwa setiap klik harus berdampak ke bisnis, bukan cuma angka di dashboard.