Kerja search engine gak dimulai pas kamu ngetik pertanyaan. Ketika kamu mengetik pertanyaan di Google dan mendapat jutaan hasil, yang kamu lihat itu bukan jawaban real-time dari Google, melainkan salinan internet yang sudah dia bangun sendiri jauh sebelumnya. Salinan itu dibentuk lewat tiga tahap: crawling, indexing, dan ranking.
Masalahnya, kebanyakan pemilik website cuma tau istilahnya doang. Crawling, indexing, ranking kedengarannya kayak mantra yang sering disebut oleh tim SEO, tapi prosesnya sendiri banyak yang gak tahu gimana jalannya.
Akibatnya, begitu ada yang gak beres dengan website mereka, mereka gak tau harus mulai ngecek dari mana. Udah post konten, submit sitemap, tapi halaman tetep gak muncul di Google. Atau pada skenario lain, halaman website muncul tapi nyangkut di halaman 7 Google yang secara praktis sama aja kayak gak ada.
Nah, di artikel ini saya bakal bedah tiga tahap itu satu per satu: gimana crawling, indexing, dan ranking bekerja, apa implikasinya untuk website kamu, dan apa yang bisa kamu lakuin di tiap tahap.
Key takeaways
Search engine bekerja dalam tiga tahap: crawling (menemukan halaman), indexing (menganalisis dan menyimpan ke database), dan ranking (mengurutkan hasil paling relevan saat ada yang mencari). Halaman yang gagal di satu tahap gak akan sampai ke tahap berikutnya.
Google tidak mencari internet secara real-time, melainkan mencari salinan indeksnya sendiri. Halaman yang belum di-crawl itu, bagi Google, sama aja gak pernah ada.
Di-crawl gak otomatis di-index. Duplicate content, thin content, dan tag noindex adalah tiga penyebab paling umum halaman lolos crawling tapi ditolak masuk indeks.
Faktor ranking punya bobot yang tidak sama. Google menjelaskan di dokumentasi page experience mereka bahwa konten paling relevan tetap ditayangkan meski page experience-nya pas-pasan. Jadi relevansi konten, otoritas backlink, dan kegunaan halaman itu jauh lebih penting daripada faktor teknis kayak kecepatan loading.
AI Overview mengubah lanskap klik. Riset SparkToro (2026) nyatet lebih dari 68% pencarian Google di Amerika Serikat berakhir tanpa klik. Jadi muncul di ranking aja sekarang gak cukup, konten kamu juga harus layak jadi sumber jawaban AI.
Apa Itu Search Engine?
Search engine adalah sistem yang tugasnya nyari informasi di internet dan nampilin hasil yang paling relevan buat pencarian kamu. Google adalah mesin pencari yang paling terkenal, tapi masih banyak mesin pencari selain Google, misalnya Bing, DuckDuckGo, Brave Search, Yandex, sampai Kagi.
Cara kerja search engine pada dasarnya sama semua: mereka gak memindai internet saat kamu mencari. Semua halaman yang mereka temukan sudah dikumpulkan lebih dulu ke dalam database raksasa yang disebut index. Pas kamu ngetik sesuatu, search engine cuma mencari di dalam database itu, bukan ke seluruh web.
Sebagai analogi, bayangkan sebuah perpustakaan. Pas kamu nyari buku, petugas gak perlu keliling ruangan buat cari bukunya. Dia cukup cek katalog, karena bukunya udah dikumpulin dan dikatalogkan sebelumnya. Search engine bekerja persis seperti itu, dan ketiga tahap (crawling, indexing, ranking) adalah proses ngumpulin dan mengakatalog-kan buku tersebut.
Buat kamu yang mau lebih dalam lagi sampai ke komponen internalnya (inverted index, link analysis, NavBoost, dua lapis ranking), saya udah bahas tuntas di artikel 8 komponen search engine. Artikel ini fokusnya ke alur tiga tahapnya, jadi kita gak bakal ngulang materi yang sama.
Bagaimana Search Engine Bekerja?
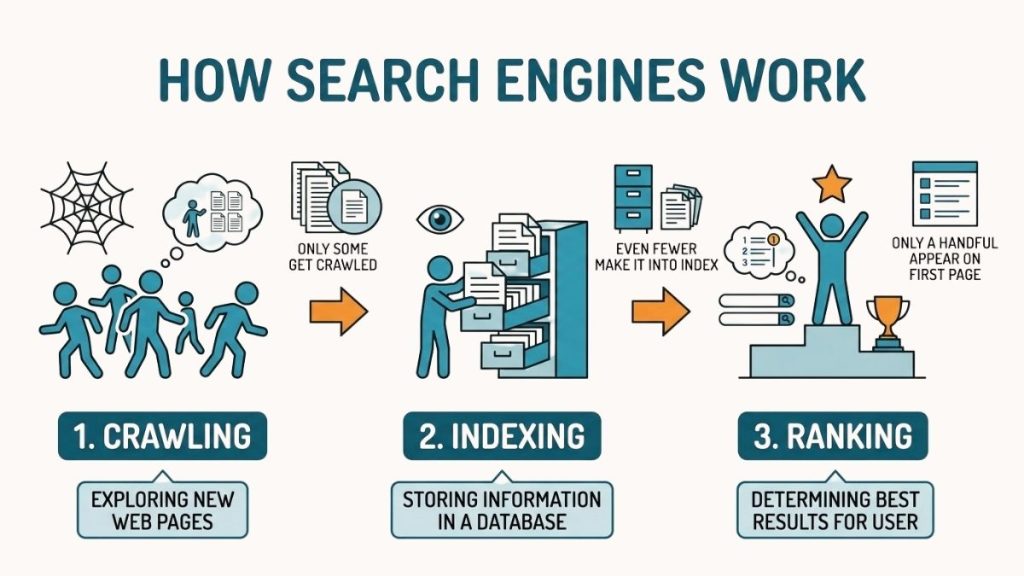
Secara garis besar, semua search engine (bukan cuma Google) bekerja dalam tiga tahap, yaitu crawling, indexing, dan ranking.
| Tahap | Fungsi | Analogi Sederhana |
|---|---|---|
| Crawling | Menemukan dan mengunduh halaman baru di web | Pustakawan berkeliling ngumpulin buku |
| Indexing | Menganalisis dan menyimpan halaman ke database | Buku dikatalogkan dan diletakkan di rak |
| Ranking | Mengurutkan hasil paling relevan saat ada yang mencari | Petugas nyaranin buku paling pas buat pertanyaan kamu |
Dalam ketiga proses tersebut, gak semua halaman lolos sampai tahap akhir. Google menjelaskan di dokumentasi resmi mereka bahwa gak semua halaman berhasil melewati setiap tahap, dan Google gak menjamin halaman kamu di-crawl, diindeks, atau ditayangkan, meskipun halaman itu ngikutin semua pedoman mereka.
Artinya, tiap tahap itu seperti corong. Ribuan halaman baru muncul tiap detik, cuma sebagian ke-crawl, dari yang ke-crawl cuma sebagian yang masuk indeks, dan dari yang masuk indeks cuma segelintir yang nongol di halaman satu.
Apa Itu Crawling?
Crawling adalah tahap pertama dalam cara kerja search engine: proses di mana search engine menemukan dan mengunduh halaman-halaman di internet.
Dalam melakukan crawling, search engine dibantu oleh program otomatis yang dikenal dengan istilah web crawler. Kamu juga mungkin sering denger istilah bot, spider, ataupun robot; semua istilah tersebut merujuk ke satu program yang sama untuk melakukan crawling.
Setiap mesin pencari memiliki crawler-nya sendiri, misalnya Googlebot dari Google, atau Bingbot dari Bing. Crawler dari nama besar seperti Google biasanya bekerja dalam skala yang gila: dia mengunduh teks, gambar, dan video dari miliaran halaman, terus ngikutin link di halaman itu buat nemuin halaman berikutnya. Semua tahap ini diulang terus menerus tanpa henti.
Bayangin pustakawan yang tugasnya ngumpulin buku dari seluruh kota. Dia mulai dari satu perpustakaan, catat semua bukunya, terus ngikutin “rujukan” di dalam tiap buku buat nemuin perpustakaan berikutnya. Begitu terus tanpa berhenti.
Fun fact: Googlebot gak crawl website kamu tanpa aturan main. Dia sengaja dirancang buat gak bikin server kamu overload. Kalau server balas dengan error 5xx, Googlebot otomatis memperlambat crawl. Jadi error pada server yang berulang itu akan jadi sinyal buat Googlebot supaya mundur.
Dalam memahami crawling, ada satu hal yang wajib kamu perhatikan: render JavaScript. Saat crawling, Google merender halaman dan menjalankan JavaScript-nya pakai versi Chrome terbaru, mirip kayak browser kamu. Rendering JavaScript ini diperlukan karena banyak website yang kontennya hanyua akan muncul setelah JavaScript jalan. Tanpa rendering, konten seperti ini tidak akan terlihat oleh Google.
Dan satu lagi: crawl budget. Googlebot gak bisa crawl semua halaman di semua situs setiap hari. Tiap situs dapet “jatah”, yaitu seberapa sering dan seberapa banyak halaman yang di-crawl. Buat situs kecil jatah itu gak pernah habis. Buat situs besar dengan jutaan URL, jatah ini jadi sumber masalah klasik. Kita bahas di bawah.
Bagaimana Googlebot Menemukan Halaman Baru?
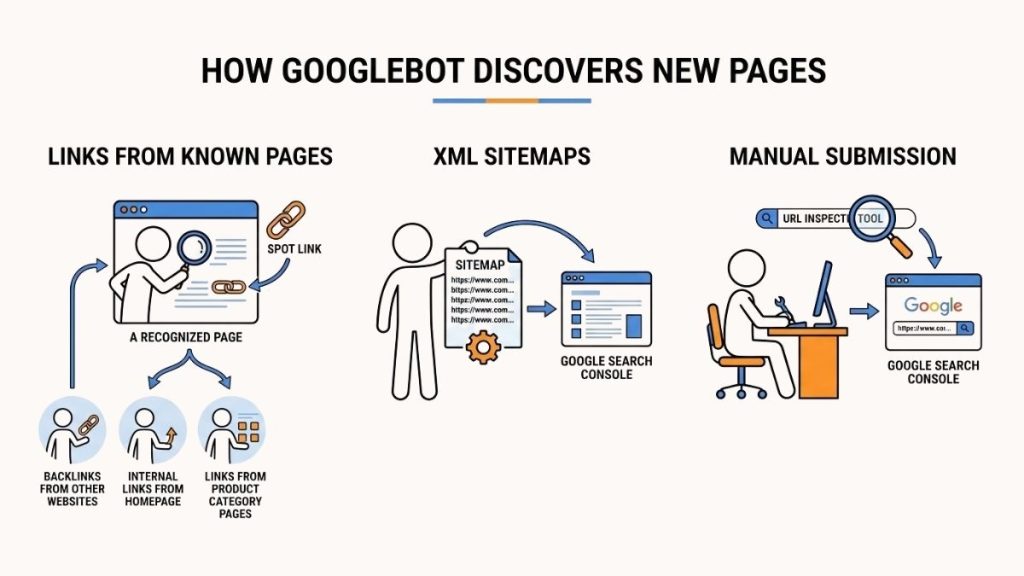
Googlebot menemukan halaman baru lewat tiga jalur utama: link dari halaman yang udah dikenal, sitemap XML, dan submit manual lewat Google Search Console. Proses ini penting dipahami karena internet gak punya registry pusat ataupun buku petunjuk yang nyatet semua halaman yang ada, jadi Google harus terus-menerus nyari halaman baru lewat jalur-jalur itu.
Rinciannya:
- Link dari halaman yang udah dikenal. Ini adalah jalur paling alami di mana Googlebot nemu link ke halaman kamu dari halaman lain yang udah dia kenal, misalnya backlink dari halaman website lain, atau internal link dari homepage kamu, atau link dari kategori produk. Artinya, halaman yang gak punya link sama sekali itu susah banget ditemukan.
- Sitemap XML. Kamu kasih daftar semua URL penting di website, terus submit lewat Google Search Console. Ini cara paling langsung buat bilang: “Ini nih, semua halaman saya, tolong diliat.”
- Submit manual. Submit manual dilakukan lewat fitur URL Inspection di Google Search Console. Kamu cukup memasukkan URL halaman kamu dan request Google untuk meng-crawl dan meng-indeks halaman tersebut. Cara ini cocok buat halaman baru yang butuh cepet ke-index.
Dari ketiganya, yang paling sering diremehin justru yang pertama, yaitu internal linking. Banyak orang sibuk submit sitemap padahal halamannya gak dilink sama sekali di situs sendiri. Halaman kayak gitu namanya orphan page: ada di sitemap, tapi gak ada satu pun link internal yang ngarah ke sana. Google bisa aja nge-crawl, tapi sinyalnya lemah dan prioritasnya rendah disbanding halaman yang memiliki internal link.
Kendala Umum Crawling dan Cara Mengatasinya
Halaman kamu gak ke-crawl biasanya karena salah satu dari lima masalah ini:
- Error 404 dan 5xx. Halaman yang dihapus tanpa redirect bakal 404; server yang nge-drop bakal 5xx. Error sesekali gak masalah, tapi kalau berulang, Googlebot makin jarang nge-mampir. Buat 404 not found, penting buat paham mana yang perlu di-redirect dan mana yang aman dibiarkan.
- robots.txt yang salah konfigurasi. Ini penyebab klasik yang paling sering bikin panik: file kecil satu baris yang ngelarang Googlebot masuk ke seluruh situs. Biasanya kejadian karena aturan
Disallow: /dari staging gak dihapus pas situs live. Cekdomainkamu.com/robots.txtsekarang juga dan pastikan tidak salah disallow. - Orphan pages. Seperti yang udah disebut sebelumnya, orphan pages adalah halaman terisolasi yang gak ada memiliki internal link dari halaman lain. Meskipun konten kamu bagus, kalau tidak dapat dicrawl maka Google tidak akan tahu kamu punya halaman tersebut. Solusinya cukup dengan menambahkan link internal dari halaman yang relevan.
- Konten di balik login atau paywall. Googlebot gak bisa isi form login. Konten yang butuh autentikasi itu, buat Google, gak ada. Jika kamu memiliki konten premium, pastikan untuk kasih akses ke Googlebot yang terverifikasi lewat reverse DNS (verifikasi Googlebot).
- Crawl budget kebuang di URL gak penting. Situs e-commerce atau situs dengan faceted navigation bisa otomatis bikin jutaan URL duplikat dari kombinasi filter dan sorting, dan halaman penting jadi gak kebagian giliran di-crawl. Ini masalah paling umum di situs besar; kita bahas detailnya plus solusinya di bawah.
Kasus paling ekstrem dari masalah crawl budget biasanya di situs e-commerce dengan faceted navigation: kombinasi filter dan sorting yang otomatis bikin jutaan URL (?warna=merah&ukuran=42, ?warna=biru&ukuran=42, dan seterusnya) padahal isinya duplikat satu sama lain. Google sendiri ngasih peringatan soal ini di panduan crawl budget mereka: kalau Google kebanyakan ngabisin waktu di URL duplikat yang gak penting, crawler bisa aja gak sempat ngejelajahi sisa situs kamu.
Solusi yang mereka rekomendasikan adalah untuk meng-konsolidasi duplicate content, dan blokir URL parameter yang gak penting lewat robots.txt. Jangan gunakan tag noindex untuk kasus ini karena Google tetep nge-request (crawl) halaman noindex. Artinya, crawl budget tetep kebuang.
Buat praktisi SEO, poinnya satu: masalah crawling hampir selalu keliatan dari data. Cek laporan Page Indexing di GSC dan crawl situs kamu sendiri pakai tool kayak Screaming Frog sebelum nebak-nebak.
Apa Itu Indexing?
Indexing adalah tahap kedua dalam cara kerja search engine di mana halaman yang udah di-crawl akan dianalisis, dipahami isinya, lalu disimpan ke dalam index, database raksasa milik search engine.
Google menyimpan indeksnya di ribuan server yang tersebar di seluruh dunia. Pas kamu mencari sesuatu di Google, yang dibandingin bukan miliaran halaman di internet, tapi salinan yang udah rapi di database ini. Makanya hasil pencarian bisa muncul dalam hitungan milidetik.
Nah, ini bagian yang sering bikin kaget: indexing itu gak dijamin. Halaman kamu bisa ke-crawl sempurna tapi tetep gak masuk indeks. Google secara eksplisit bilang gak setiap halaman yang diproses bakal diindeks. Dan mereka gak salah, karena itu memang saringan kualitas mereka.
Lanjut analogi perpustakaan: pustakawan gak mau nyimpen fotokopian berkualitas buruk, buku yang isinya sama persis sama buku lain, atau brosur setengah halaman. Rak perpustakaan itu mahal, jadi yang masuk harus layak.
Apa Saja yang Dianalisis Saat Indexing?
Selama proses ini, Google “membaca” halaman kamu dan mencatat banyak hal:
- Kata kunci dan topik. Apa isi halaman ini? Untuk pertanyaan kayak apa halaman ini jawabannya?
- Elemen struktur. Title tag, heading (H1, H2, H3), meta description: semua ini bantu Google paham fokus halaman. Google sendiri pernah konfirmasi bahwa heading dan penekanan teks yang wajar bantu mereka paham bagian mana yang dianggap penting oleh penulisnya.
- Konten non-teks. Gambar (dibaca dari alt text dan konteksnya), video, dan dokumen lain.
- Structured data. Schema markup kayak JSON-LD yang menjelasin “ini halaman produk”, “ini resep”, “ini event”. Konteks tambahan semacam ini bisa memunculkan rich results.
- Freshness. Kapan halaman ini terakhir di-update? Topik yang butuh info terkini dinilai berbeda dengan topik yang statis.
- Versi mobile. Sejak mobile-first indexing, yang jadi acuan utama Google itu versi mobile halaman kamu. Konten yang cuma muncul di desktop itu, buat Google, setengah ada.
- Canonicalization. Google ngelompokin halaman-halaman yang isinya mirip (duplikat atau nyaris duplikat), terus milih satu sebagai canonical, yaitu versi resmi yang diwakilin di hasil pencarian. Sisanya disimpen sebagai versi alternatif. Sebagain contoh,
domain.com/halamandandomain.com/halaman?ref=fbgak dianggap dua halaman terpisah, dan makanya tag canonical itu penting buat ngarahin versi mana yang resmi.
Kenapa Halaman Kamu Gak ke-Index Padahal Udah di-Crawl?
Penyebabnya paling sering empat hal: kualitas konten yang rendah, duplicate content, tag noindex, dan masalah rendering. Semuanya nongol di GSC dengan status yang paling bikin frustrasi: “Crawled – currently not indexed”. Kode tersebut menandakan bahwa Googlebot udah mampir, baca halaman kamu, terus pulang tanpa nyimpen apa-apa. Rinciannya:
- Kualitas konten rendah. Halaman tipis, gak ada info baru, atau cuma nge-parafrase halaman lain. Google nge-saring halaman yang gak nambah nilai buat pengguna.
- Duplicate content. Isinya nyaris identik sama halaman lain, baik di situs sendiri maupun di web. Google pilih satu canonical aja, sisanya gak di-index.
- Tag noindex. Kadang sengaja (halaman thank-you, hasil pencarian internal), kadang gak sengaja: template lama atau plugin SEO yang settingannya kebawa.
- Masalah rendering. Konten utama cuma muncul setelah JavaScript jalan, dan sesuatu gagal pas render. Google nyatet halaman itu “kosong” makanya tidak diindeks.
Cara ngeceknya: buka Google Search Console → URL Inspection, masukin URL, liat statusnya. Kalau statusnya “URL is not on Google,” GSC bakal kasih alasan detail di tab “Page indexing”. Dari situ kamu tau harus benerin apa.
Dan karena kita di sini, ada mitos yang perlu dilurusin. Banyak yang ngerasa “situs saya udah ke-index tahun lalu, jadi semua halaman baru pasti otomatis ke-index juga” padahal itu salah. Indexing itu per-URL, bukan per-situs. Artinya, halaman baru kamu dinilai sendiri-sendiri, dan halaman lama yang ke-index gak kasih jaminan apa-apa buat halaman baru. Mitos lain adalah “saya udah submit lewat GSC, berarti pasti ke-index.” Ini juga salah karena submit itu cuma ngajuin, sedangkan keputusan tetep di sisi Google.
Apa Itu Ranking?
Ranking adalah tahap ketiga dan terakhir di mana search engine akan mengurutkan halaman-halaman yang udah masuk indeks berdasarkan relevansi saat ada yang mencari. Berbeda sama crawling dan indexing yang berlangsung jauh sebelum kamu ngetik apa-apa, ranking adalah satu-satunya tahap yang kejadian saat kamu mencari.
Lanjut analogi perpustakaan tadi: kalau crawling itu ngumpulin buku dan indexing itu ngatalogin, ranking itu saat petugas nyaranin buku paling pas buat pertanyaan kamu. Dia gak pergi ke mana-mana lagi, cukup buka katalog yang udah ada dan nyusun yang paling relevan di urutan teratas.
Satu anggapan lama yang perlu dilurusin: ranking nomor satu gak lagi jamin traffic. Riset SparkToro (2026) berbasis data Similarweb nyatet 68,01% pencarian Google di Amerika Serikat antara Januari sampai April 2026 berakhir tanpa satu klik pun ke luar halaman hasil, naik dari 60,45% di 2024.
Sementara SISTRIX (Februari 2026), yang menganalisis lebih dari 100 juta keyword di pasar Jerman, nyatet CTR posisi satu organik anjlok dari 27% ke 11% di kueri yang nampilin AI Overview, rangkuman jawaban yang disintesis AI dan ditampilin di atas semua hasil organik.
Karena AI dan perubahan perilaku pengguna, muncul di ranking aja sekarang gak cukup, konten kamu juga harus layak jadi sumber yang dikutip AI. Kabar baiknya, yang kedua biasanya berujung ke hal yang sama: jawab pertanyaan secara eksplisit di awal, struktur konten yang jelas, data original, dan otoritas topik otomatis kamu memiliki peluang lebih besar dikutip AI.
Bagaimana Algoritma Google Menentukan Urutan Hasil?
Algoritma Google menentukan urutan hasil lewat lima penilaian utama: makna kueri, relevansi halaman, kualitas konten, usability, dan konteks pencarian kamu.
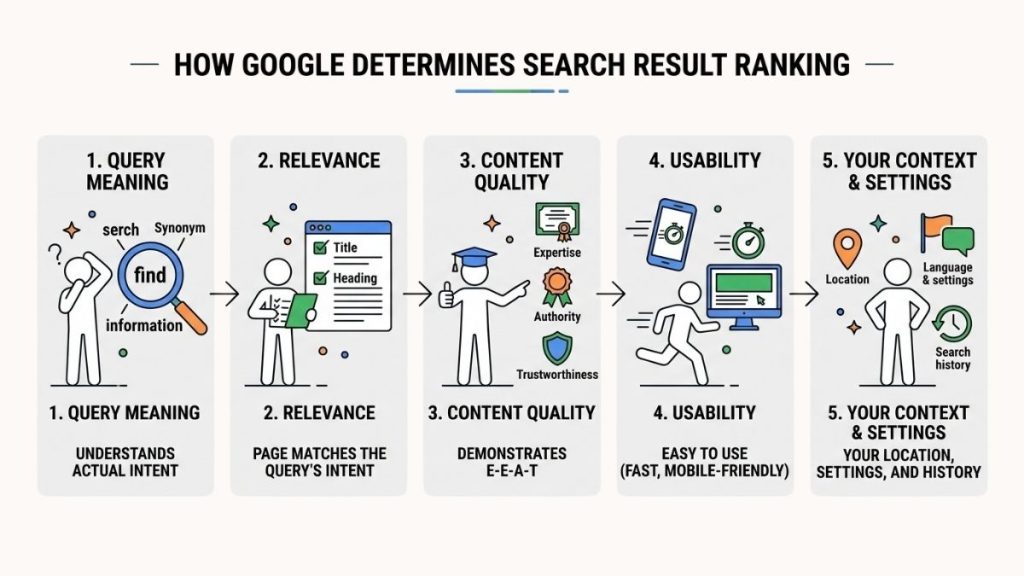
Rinciannya:
- Makna kueri. Google coba paham apa yang sebenarnya kamu maksud, termasuk koreksi typo, sinonim, dan konteks pencarian.
Contoh dari Google sendiri: kamu cari “change laptop brightness”, tapi produsennya nulis “adjust laptop brightness”. Sistem Google ngerti kedua kata itu nyambung, jadi kamu tetap dapet halaman yang tepat. Di balik layar ada sistem AI seperti BERT yang bantu Google paham gimana kombinasi kata bisa bermakna beda, dan neural matching yang mencocokkan konsep di kueri dengan konsep di halaman. - Relevansi. Apakah halaman di indeks sesuai dengan maksud kueri? Google liat ke title, heading, dan isi kontennya. Tapi Google juga ngecek apakah halaman punya konten pendukung lain.
Contohnya: kalau kamu cari “dogs”, kamu pasti gak mau halaman yang nyebut kata “dogs” ratusan kali. Algoritma nilai apakah ada gambar, video, atau daftar ras anjing di dalamnya. Google juga bisa menilai per bagian halaman lewat sistem passage ranking, jadi satu paragraf yang pas bisa ngangkat halaman yang bagian lainnya biasa aja. - Kualitas konten. Dari halaman yang relevan, mana yang nunjukin keahlian, otoritas, dan kepercayaan (E-E-A-T)? Salah satu sinyal yang digunakan Google adalah mereka melihat apakah situs otoritas lain nautin atau ngerujuk ke konten itu.
- Usability. Halaman yang gampang dipake (cepet, mobile-friendly) dapet poin tambahan. Tapi ini berlaku kalau semua sinyal lain relatif setara. Jadi usability itu pembeda di kondisi imbang, bukan pengganti konten yang bagus.
- Konteks dan pengaturan kamu. Lokasi, bahasa, perangkat, dan riwayat pencarian. Bobot tiap faktor juga gak tetap, tergantung jenis kueri. Buat berita terkini, freshness berperan lebih besar daripada buat definisi kamus.
Poin terakhir itu gampang dibuktikan. Coba cari dengan kata kunci “warung kopi” dari Jakarta, terus cari kata yang sama dari Medan. Hasil pencarian yang muncul pasti berbeda karena Google nampilin yang deket sama lokasi kamu.
Dan satu hal yang penting dipahami: algoritma ranking terus berjalan dan diupdate oleh Google. Google rilis core update beberapa kali setahun, dan tiap update bisa menggeser ranking. Makanya ranking itu gak pernah “selesai”. Situs yang ranking hari ini bisa turun besok kalau kompetitor-nya lebih relevan atau algoritma berubah.
Faktor Penentu Ranking Pencarian
Kalau ditanya “apa faktor ranking terpenting,” jawaban jujurnya: ada ratusan, dan bobotnya gak sama. Google gak pernah ngerilis bobotnya, jadi ini bukan peringkat resmi. Tapi tujuh faktor ini yang paling konsisten berpengaruh:
- Relevansi kata kunci. Halaman kamu harus beneran jawab pertanyaan yang dicari, mulai dari title, heading, sampai isi konten. Bukan keyword stuffing, tapi pencocokan makna. Orang yang nyari “resep nasi goreng” gak mau halaman yang nyebut “nasi goreng” seratus kali tapi gak ada takarannya.
- Kualitas konten dan E-E-A-T. Konten yang orisinal, lengkap, ditulis dari pengalaman nyata, dan bisa dipertanggungjawabkan. E-E-A-T itu kerangka penilaian, bukan satu skor yang dihitung algoritma.
- Backlink dan otoritas domain. Link dari situs lain itu kayak rekomendasi. Satu backlink dari situs otoritatif di topik kamu umumnya jauh lebih berharga daripada seratus backlink dari situs random.
- Search intent. Ini yang paling sering diabaikan. Kalau semua orang yang cari “cara kerja search engine” pengen panduan lengkap dan halaman kamu cuma 200 kata definisi, kamu gak akan menang, sebagus apapun backlink kamu. Konten yang gak match intent gak akan ranking, titik.
- Sinyal interaksi pengguna. Google ngaku pakai data interaksi agregat buat menilai relevansi. Di sidang antitrust DOJ, terungkap sistem Navboost yang ngerapiin ranking berdasarkan data klik, dan Google sendiri nyebutnya salah satu sinyal terkuat meskipun bobot persisnya gak diketahui.
- User experience dan Core Web Vitals. Kecepatan, stabilitas visual, responsivitas mobile. Bobotnya lebih kecil dari konten, tapi dia tie-breaker: pas dua halaman sama-sama relevan, yang lebih nyaman dipake menang.
- Keamanan (HTTPS). Sinyal ranking ringan, bukan pembeda utama. Tapi tetep wajib: browser nandain situs HTTP sebagai gak aman.
- Kondisional: freshness. Buat berita dan tren, konten lebih baru diprioritaskan. Buat topik evergreen, pengaruhnya kecil.
Mitos favorit yang masih hidup sampai sekarang: “skor Core Web Vitals sempurna = ranking naik.” Gak gitu. Google sendiri bilang skor bagus di Core Web Vitals gak menjamin halaman kamu ranking teratas, dan ngejar skor sempurna cuma demi SEO belum tentu worth it. Yang penting halamannya nyaman dipake. Sisanya tetep balik ke konten yang relevan.
Bagaimana Cara Bikin Website Mudah Ditemukan di Search Engine?
Bikin website mudah ditemukan artinya mastiin dia lolos di tiap tahap: gampang di-crawl, layak di-index, dan relevan buat ranking. Karena cara kerja search engine itu tiga tahap, optimasinya juga paling efektif kalau dipikirin per tahap.
Biar gampang di-crawl:
- Cek
robots.txtkamu, pastiin gak adaDisallowyang ngeblokir halaman penting. - Pastiin tiap halaman penting bisa diakses dari homepage dalam beberapa klik, lewat navigasi atau internal link.
- Perbaiki internal link yang rusak, karena link ke 404 itu buang crawl budget dan link equity sekaligus. Kalau halaman pindah permanen, pakai redirect 301 yang benar, jangan asal lempar ke homepage.
- Buat situs besar, benerin URL duplikat dari parameter dan filter biar crawl budget fokus ke halaman penting.
Biar gampang di-index:
- Submit sitemap XML lewat Google Search Console.
- Bikin konten yang nambah nilai, bukan parafrase dari halaman yang udah ranking.
- Pantau laporan Pages di GSC. Status “Crawled – currently not indexed” dalam jumlah besar itu alarm kualitas konten atau duplikasi.
- Cek tag noindex di halaman yang memang harus ke-index.
Biar ranking:
- Cocokin konten sama search intent-nya, bukan cuma sama keyword-nya.
- Jawab pertanyaan utama secara eksplisit di awal artikel. Ini penting buat featured snippet dan sekarang juga buat AI Overview.
- Bangun otoritas topik: banyak halaman saling terkait di satu bidang, bukan situs serba ada. Ini cara kamu keliatan relevan sebagai satu kesatuan, bukan halaman lepas.
- Dan yang paling penting dari semuanya, yang sering dilupain: bikin konten yang beneran bermanfaat. Model bisnis Google Search adalah menyajikan hasil terbaik buat penggunanya. Semua trik di atas cuma mempercepat hal yang layak. Dia gak bisa menyelametin konten yang gak layak.
Kesimpulan
Search engine bekerja lewat tiga tahap: crawling buat nemuin halaman, indexing buat nyimpen ke database, dan ranking buat ngurutin hasil paling relevan saat ada yang mencari. Tapi jangan berhenti di situ, karena tiap tahap itu corong, dan corong itu bisa dipakai jadi peta diagnosis.
Halaman kamu yang gagal di Google pasti berhenti di salah satunya: gak muncul sama sekali biasanya soal crawling (gak ada link yang ngarah ke halaman, atau robots.txt ngeblokir), masuk laporan Pages tapi statusnya “Crawled – currently not indexed” soal indexing (kualitas konten atau duplikat), dan udah ke-index tapi gak pernah nongol soal ranking (intent gak match atau relevansi kalah).
Kalau kamu mengalami hal tersebut, segera buka Google Search Console, liat laporan Pages-nya, dan cek halaman kamu nyangkut di corong mana. Setelah tahui penyebabnya, barulah perbaiki sesuai tahapnya.
FAQ: Cara Kerja Search Engine
Apa perbedaan crawling, indexing, dan ranking?
Crawling: search engine menemukan dan mengunduh halaman kamu. Indexing: halaman dianalisis dan disimpan ke database. Ranking: saat ada yang mencari, algoritma ngurutin halaman yang paling relevan dari database itu. Bisa diibaratkan: crawling itu ngumpulin buku, indexing itu ngatalogin, ranking itu nyaranin buku paling pas. Halaman harus lolos satu tahap buat bisa lanjut ke tahap berikutnya.
Berapa lama Google mengindeks halaman baru?
Gak ada angka pasti dari Google. Halaman bisa ke-index dalam hitungan jam sampai beberapa hari, tergantung otoritas situs, seberapa sering di-crawl, ada gak sitemap dan internal link yang ngarah ke halaman itu. Situs yang aktif dan sehat biasanya lebih cepet. Cara mempercepat: submit lewat URL Inspection di GSC dan pastiin halaman dilink dari situs sendiri.
Bagaimana cara cek apakah halaman saya sudah diindeks Google?
Cara tercepat: ketik site:domainkamu.com/nama-halaman di Google. Kalau muncul, ke-index. Tapi cara yang paling akurat itu Google Search Console → URL Inspection: dia kasih status resmi plus alasan kalau halaman gak ke-index. Buat gambaran keseluruhan, cek laporan Indexing → Pages di GSC.
Apakah saya bisa ngatur seberapa sering Googlebot crawl situs saya?
Tidak ada lagi. Google pernah nyediain setting crawl rate di Search Console, tapi udah dihapus sejak akhir 2023. Frekuensinya sekarang sepenuhnya ditentukan Google berdasarkan kesehatan server, popularitas, dan freshness konten kamu.
Siapa Pici?
Saya Pici, dengan nama asli Muhammad Fikri Abdul Zaki. Sudah 10+ tahun di dunia SEO, dan saya meyakini bahwa setiap klik harus berdampak ke bisnis, bukan cuma angka di dashboard.